
 最新跨境运营干货
 看多维度榜单信息
平台官方数据指的是哪些
平台官方那一层,指的是这个平台自己在自己的页面上公开摆出来的东西。你打开某一款的页面,看到的标题、价格、类目、摆出来的评价条数与销量区间,这些就是官方那一层。它不用你去问谁,打开就有,谁进这个页面看到的东西都一样。
官方那一层还有一个特点:它是按单个东西摆的。你看的是某一款的页面,它给你的也就是这一款的几项。它不会顺手把同类里别的款也摆给你,也不会告诉你这一类整体怎么样。这一点决定了这一层只能回答这一款的问题,回答不了整类的问题。
还有一层是平台自己发布的汇总,比如它办的活动页、它给的类目入口、它自己在帮助中心写的规则说明。这些东西也算官方那一层,但它是按整类或者按平台规则说话的,跟单款那一层不是同一个层面,两种不能混着用。
具体一点:你在帮助中心看到一条关于退货规则的说明,又在某一款的页面上看到它的价格。这两条都是官方的,可一条是整平台通用的,一条是那一款此刻的样子。你拿通用的那一条去解释那一款,多半会解释不通,因为它们说的话不在同一个层面上。
官方那一层更新得比较勤,价格和活动这一类东西随时会动,销量区间也会跟着走。但你没法把官方的每一页都翻一遍,尤其站点多、类目多的时候。这就是为什么会有第三方一类的东西出现,它替你把翻的动作提前做完,代价是它翻的时候不是你在翻。
具体一点:你想知道某一小类这一个月有没有在动,靠官方那一层你得一款一款点开看,看几十款才能有个大概。这类站点做的事情就是把这一步提前替你做掉,它翻完整理好,你打开就有一屏。省下的时间是真的,代价是那一屏是它翻的时候的样子。
官方那一层也不等于全部的真实。页面上摆着的评价条数、销量区间,是它愿意公开的部分;真实的成交、真实的退货、真实的成本,都不在这一层上。你把官方那一层当成全部的真实,后面很容易在某一处对不上,而对不上的那部分本来就从来没公开过。
具体一点:你在某一款的页面上看到一个销量区间,又听别人说这一款其实卖得挺多。两个说法不一定冲突,因为一个人说的是这一页你所在的这个站点,另一个人说的可能是另一个站点上的情况,也可能是他自己那家的情况,两件事本来就不是一件事。
还有一层官方的东西是平台自己给的规则与统计口径说明。这一类内容不告诉你哪个东西卖得好,它告诉你平台是怎么数、怎么算的。这一层最有价值的地方在于,它可以拿来核对别人的算法,你看到某一边给你一个数,可以回头看看官方对同一件事是怎么定义的。
具体一点:某一边告诉你某一类的均价,你手里有官方对这类的定义,两者一对,你就知道它算的是哪一档。这个动作在两边对不上时特别管用,因为很多时候差别就是出在对同一类的边界划得不一样,一边划宽了,一边划窄了。
官方那一层是所有人都拿得到的一层,正因为谁都拿得到,它自己不带任何优势。它的优势在于它是原生的,没有经过第二道手。任何第三方给你的数,多多少少都经过了一道处理,那一道处理带来的便利和它带来的距离,是一起给你的,不是只给其中一样。
拿知虾对照一下:它给的是同类目同层级里横向摆得齐的那几个数,你能比的只在这几个数之间。这句话说明它给的是整理过的那一层,不是官方页面上一款一款的样子。两种都各有各的用法,分清了你就知道手上这一份该用在哪一步。
收一句:官方那一层是你核对别的来源时的一个参照,它不一定是最方便的一层,但它是离源头最近的一层。你手上不管有多少种来源,留一条回到它的路,心里就踏实,因为别的来源对不对得上,最后总得回到源头那里看一次。
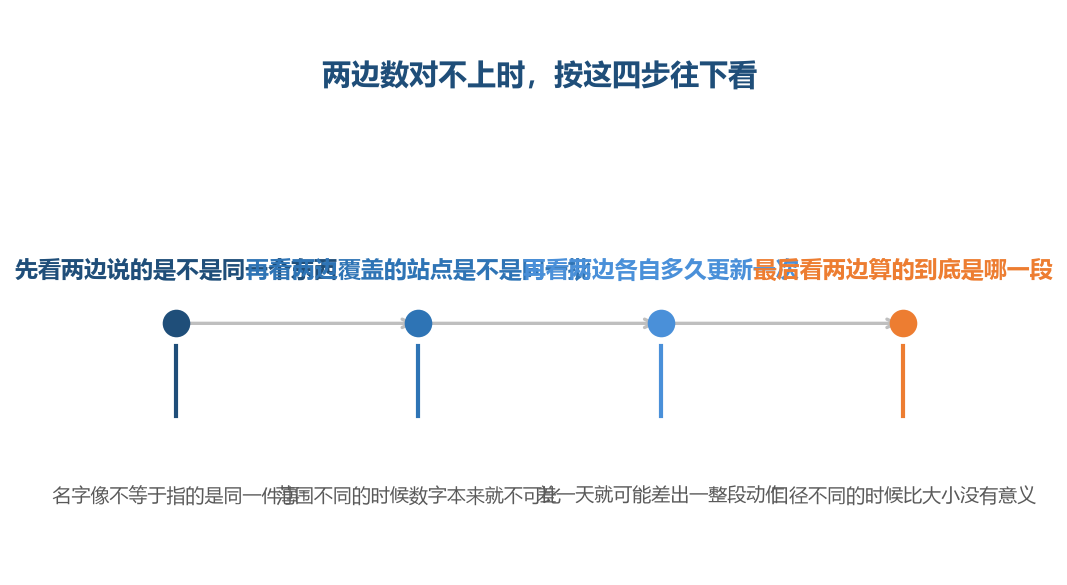
这四步的次序不要换,换一步就会在错的地方找原因
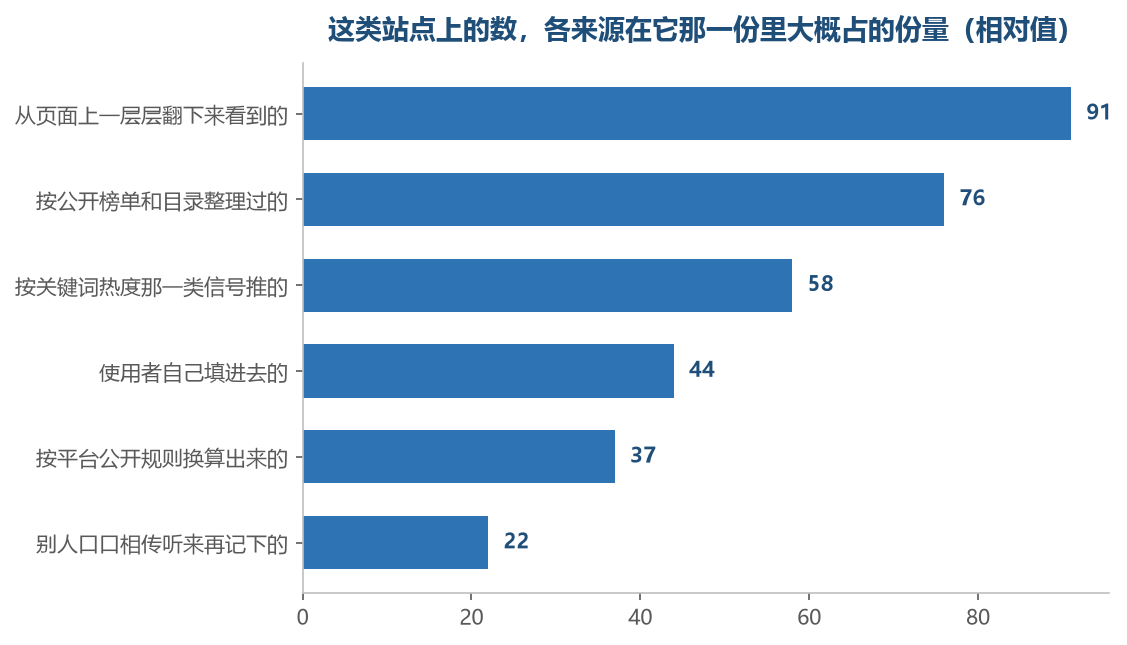
这类站点的数从哪来
最常见的一路,是它自己按固定的节奏去平台上看公开页面,把看到的记下来、整理好,再摆给你。它翻的是谁都能打开的那些页面,翻完存成自己那一份,你打开它看到的就是它存下来的那一份。这一路的好处是不用你做什么,代价是它是它翻的,不是你在翻。
第二路是从公开的榜单和目录里整理。平台有时候会摆出一些类目入口、活动页、榜单,这类站点把这些收下来,按自己的办法重新排一排。这一路拿到的东西本来就经过平台一次整理,它再整理一次,两道处理叠在一起,便利和距离也跟着叠。
第三路是按信号推。它不直接拿某一款的数,而是看搜索热度、看关键词、看类目里的上新节奏这一类侧面信号,用这些推一个大概。这一路给的东西通常更宽、更粗,它适合看整片的方向,不适合看某一款的具体情况,两种活不能混着做。
具体一点:你在一处看到某一小类的热度在涨,这是推出来的,不是数出来的。它的意思是这一片最近被搜得多了,不意思是这一片里每一款都在涨。你拿它去决定某一款要不要做,跨度太大,中间那一段还需要别的东西来填。
第四路是使用者自己填。有的地方让你把自己知道的数录进去,凑成一份大家共用的东西。这一路的特点是它顺手,你录完马上有得看;它的特点也是它顺手,谁都可以录,录进去的东西对不对,谁来核,这件事通常没说清楚。
具体一点:你在一份共用表里看到某一款的数据,来源是别人填的。这一条对你有没有用,取决于填的人是不是也在这个站点做、是不是同一个类目、是不是同一段时间。这三点不问清,那一条就只是一个数,跟你想问的事情之间隔着好几层。
第五路是换算。它手上有一部分真实的东西,再用一套换算办法推出它没有的那一部分,比如按类目均价推某一档的大概情况。这一路的数看着挺具体,可它是算出来的,算法一变结论就变,你用它的时候心里要清楚这一层是推算不是实录。
具体一点:某一处给你一个估出来的量级,你去平台上看那一款,发现页面上并没有这个数。这不是它编的,是它按自己那套办法推出来的。推算本身没有问题,有问题的是你把它当成实录,然后拿它去核一个实录的数,两件事本来不同类。
这几路往往不会只走一条,多半是混着的:一部分自己翻来的,一部分从公开榜单整理的,一部分推算的,一部分从别处搭过来的。混着来本身没问题,问题是分不清你手上这一条是哪一路来的,因为每一路能撑到的位置不一样,混了之后就不知道能用到哪一步。
具体一点:同一屏上有两条记录,一条是它自己翻到的,一条是推算出来的,两条长得一模一样,都是几列数字。你不去分辨,自然会按同一种信任度去看它们,可一条能拿去对照另一个来源,另一条只能当方向,这个差别在你做判断的时候很关键。
分辨的办法其实不难:看它有没有把来源写在旁边。写了来源的,你能顺着摸到它翻的那一页;没写的,你就只能按它给的数用。这个动作花不了几秒钟,可它能帮你在一屏里分出哪几条是可以去核的,哪几条只是给你一个方向,不要拿去核。
还有一层要提前知道:它翻的时候翻的是公开的那一层。页面上没有的东西它翻不到,后台那份东西它更翻不到。所以这一类站点给你的数,天花板就在公开那一层上,你把期待放在那一层以内,它一直够用;放到那一层以外,你会一直觉得少了点什么。
具体一点:你在这一类站点上看到某一款这一类里横向摆得齐的几个数,这是公开那一层里横向比出来的。你想知道某一款在你手上能不能做、成本能压到多少、这个月能出多少单,这些数不在这类站点的来源范围里,它也没有这份来源。
拿知虾来对照这几路来源,会比较容易看清:它的功能范围自己有一份官方说明,照着看就知道它给的这一份数走的是哪一条路。上面这几路来源是这一整类站点共同的结构,认清了结构,你就不用一家一家去问,看一眼它摆出来的东西就能归进去。
收一句:这一节的要点是,数从哪来决定了它能用在哪一步。同一屏上几条来源不同的记录,长得一样,能撑到的地方却不一样。你在用之前先分清来源,比用什么办法去核都更省事,因为来源不同这件事本身就先替你划掉了几个不该用到的位置。
越靠上的越是它自己能直接碰到的,越往下越依赖别人先给出来一份
第一处关系:覆盖范围不同
覆盖范围指的是它翻了哪几个地方。不同的东西翻的范围不一样,有的只翻一个站点,有的翻好几个站点。你在一边看到的数,可能只覆盖一个站,另一边那个数覆盖了三个站。两边说的是不同的地方,拿来做比较,自然对不上,这跟谁算得对不对没有关系。
具体一点:你关心的东西在三个站点上都卖,A 那边只翻了其中一个,B 那边三个都翻了。你在两边各看一个数,这两个数的份量本来就不一样,一个是一个站的样子,一个是三个站合起来的样子。不把这一层摆在前面,比出来的差别全是范围造成的。
覆盖面还有一个方向的问题:它翻的是这个类目整体,还是只翻了最上面那一层。翻整类的和只翻前几页的,份量完全不同。你看到一边说某一类里有一千多个东西,另一边说只有两百个,这中间差的那八百个,多半是两边翻的深度不一样,不是有一边漏了。
具体一点:你看到两边对同一小类的收录条数差了好几倍,先别急着下判断。回头看看两边各自翻了多少页、按什么条件筛的。翻得浅的那一边看到的是最活跃的那一批,翻得深的那一边看到的是全部,两种范围都有用,但它们的结论不能互换着用。
还有一层是站点的差别:不同站点上同一类东西的规模本来就不一样。一个站点上这一类有两百款,另一个站点上可能有八百款。你在两个站点之间看到一个数大一个数小,这个差别可能来自这个站点本身,跟两边的办法没有什么关系,这一点最容易误读。
具体一点:你看到某一个数在一个站点上明显大,另一个站点上小很多,先想一下这两个站点的体量是不是本来就差好几倍。如果是,那这个差别属于地方性的差别,跟你怎么算关系不大。很多人在这里会去找算法的问题,其实地方本身就不同。
覆盖面还能帮你判断一条记录的可用范围:如果一个来源只翻了一个站点,而你要看的是跨几个站点的对比,那它给的那一条只能用作其中一个站点的样子,不能拿来代表整体。你把它当成整体去用,得出来的结论就会偏,而且偏的方向还不明显。
具体一点:你要在三个站点之间比某一类的价格,手上只有一个站点的数。这时候你手上有的是一角,不是全部。你可以拿这一角当一个参照,可你不能说三个站点都是这个样子,因为另外两个站点你可能连它们这一类有多少东西都不知道。
范围这件事值得在开始用之前先问清,而且问法很简单:你翻的是哪几个站点、翻到第几层、按什么条件筛的。这三个问题问完,你手上这一份的覆盖面就定了。定了之后,你再看它的数,就知道哪些能比、哪些只能单独看,不用每次重新猜。
具体一点:你问清它只翻了两个站点,那你在看跨三站点的对比时就会自动留一格空着。这一格空着比填一个错的数要好得多,因为空着你知道自己缺什么,填错了你不知道。留白这件事在用这一类东西的时候,比凑满更重要。
还有一种情况是范围会变。它这个月翻三个站点,下个月可能加了两个,也可能减了一个。范围一变,它给的汇总数前后就不可能直接比,因为比的东西不一样了。你要长期跟踪某一类,得留意它有没有在某个月换了范围,不然你会把范围的变化读成行情的变化。
具体一点:你三个月里每月抄一次某个数,看到它连着两个月涨。回头一查,中间那个月它多翻了一个站点。那一次上涨里有一部分是新站点带来的,不是原来的东西在涨。这个坑不难躲,只要你抄的时候顺手把范围也抄一行就够了。
收一句:覆盖范围是最先显出差异的一处,也是最容易被当成算法差异来讨论的一处。先把它排掉,后面才轮到讨论节奏和口径。不排掉它,你会在一个本来就不可比的地方反复找原因,找到的原因是假的,改动也就改在了用不着改的地方。
| 这会带来什么差别 | 对不上时先看什么 | 最容易犯的错 | ||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 它 | 翻 | 的 | 站 | 点 | 少 | , | 他 | 翻 | 的 | 站 | 点 | 多 |
| 先 | 数 | 两 | 边 | 各 | 覆 | 盖 | 了 | 几 | 个 | 站 | ||
| 把 | 只 | 覆 | 盖 | 一 | 个 | 站 | 的 | 数 | 当 | 成 | 整 | 体 |
第二处关系:更新节奏不同
更新节奏指的是它多久动一次。有的是当天就动,有的是隔一天动,有的按周动,还有的隔一段才补一版。节奏不同,你手上那一份数的年纪就不同。两个来源对不上,有时候只是其中一个还没到该动的时候,它给的还是上一轮的样子。
具体一点:一边是前一日的,一边是当天的,你在一个正在动的类目上比这两个数,差别可能全是那一天的差距。价格在活动前后一天能差出一档,销量区间也能跟着跳。这时候对不上的原因不是算法,是你把两个不同年纪的数放在一起比了。
节奏还分两种:一种是它按固定时间自己去动,一种是它要有人去推才动。前者你放着不管它也会变,后者你不去动它就一直是上一次的样子。这两种节奏的手感差得很远,可它们表面上都只是一个页面,你不去留意就分不出来。
具体一点:你隔一周打开同一个页面,看到内容完全没变,有两种可能。一种是它本来就是一周才更新一次的那一类,另一种是它需要有人去推一下。两种情况下你能做的事不一样,可你看页面上的样子是分不出来的,得去问或者去试一次。
节奏还有一个容易忽略的地方:不同站点的更新节奏可能不一样。同一个东西,在一个站点上是前一日更新的,在另一个站点上可能还停在几天前。你把这个站点上的数拿去和那个站点上的数比,比出来的差别里有一部分是时间差,不是地方差。
具体一点:你比两个站点上同一类的价格,一个站点的数是前一日的,另一个站点上是三天前的。这三天里如果有一场活动,那这个价格差别里就掺着活动带来的变化。你不知道这一层,会以为这两个站点的价格水平本来就差这么多,结论就错了。
节奏还能帮你安排自己看的频次。如果它本身就是隔一天才动一次,你每天去看也看不出变化,白花时间;如果它当天就动,你隔一周去看一次,中间那些天的动作你一个都没接到。看它的频次跟着它的节奏走,这样最省力,也不容易漏。
具体一点:你手上这一个给的是前一日的数,那你就按一天看一次的节奏用,一天看三次也是同一份东西。反过来,如果你手上那一个一周才动一次,你天天去翻也翻不出新的,那几天的时间不如花在别处,这就是跟着节奏走的意思。
两边对不上时,节奏这一处值得第二个查。因为节奏差异带来的差别平时看着不大,一旦碰上活动或者上新,它能在一天之内造出一个看着很大的差别。你先把时间对齐,剩下的差别才有可能是别的原因,不然你找的方向一直是错的。
具体一点:你先问清两边各自多久动一次,再看你手上的两个数分别是什么时候的。如果两边差了一天,你就先把这一天的距离放到一边,看剩下还有没有别的差别。很多时候放掉这一天之后,两边的数其实就差不多对上了。
还有一层是它更新的时间点。有的在凌晨动,有的在白天的某个时候动,有的不定。这一点在你安排自己的活的时候有用:你知道它几点动,就能在它刚动完之后用上最新那一份,而不是在它快要动之前去做一遍等会儿就过期的判断。
具体一点:你知道它在早上某个时间换一次内容,那就把要看的活安排在那之后,看到的是这一轮最新的。你要是安排在那之前,看到的还是上一轮的,做完判断没多久它就换了,前面那一趟就白跑了,这一件事只需要知道一次就够。
收一句:更新节奏这一处,平时最容易忽略,因为它只有在动得快的时候才让人看出来。平时两边差一天你也不觉得,等到价格跳档的时候你才发现。所以这一处要提前记在心里,不要在出了问题之后才回头算两边到底差多久。
第三处关系:口径可能不同
口径指的是它怎么数、算的是哪一段。同样一批东西,按整类合起来算和按单款分开算是两个结果,按最近一周和按最近一月也是两个结果。口径不同的时候,两个数放在一起比大小没有意义,因为它们在说的是两件事,只是长得像。
具体一点:一边告诉你某一类的热度,另一边告诉你这一类里某一款的热度。这两个数看着都在说这一类,可一个说的是整片,一个说的是里面的一点。你拿整片去对一个点,得出的结论必然偏,而且偏的方向取决于这一片里席位的分布。
分档也是口径的一处。有的把几个价格档合起来算一个数,有的一个档一个数。合档的那一个看着稳,其实它把几段不同的情况抹平了;分档的那一个看着细,其实每一档里的样本少,波动更大。两种各有各的用法,混着比就不成立。
具体一点:你在一边看到一个排得很前的类目,那是几个档位合起来排的;另一边同样的类目排得靠后,因为它是单看某一个档位。两个都没错,可你心里想说这一类现在很热,其实你想说的可能是某一个档位很热,这句话的落点不一样。
时间窗口是口径里最常出问题的一处。按最近一周算的会放大最近的动作,按最近一月算的会把最近的动作摊薄。你拿一周窗口看到的涨幅去对一个月窗口看到的涨幅,一个显得猛一个显得稳,其实东西没变,只是两个窗口看的是一件事的两个切面。
具体一点:某人告诉你某一款最近很猛,另一个地方告诉你这一类整体一般。两个人可能都在说实话,一个看的是最近几天,一个看的是整个月。你如果只挑一个记下来,后面做事的时候就会跟你当时看到的那一个不同步,因为动的东西一直在动。
还有一层是算的对象是谁。有的数的是上架的款,有的数的是有动静的款,有的数的是被看过的款。这三种数出来的东西完全不一样,可它们在页面上都只是一个数字。你不问清它数的是哪一类对象,就没法知道这个数在说哪件事。
具体一点:一边说某一小类里有三百个款,另一边说有八十个款。差别可能在一边数的是全部上架的,另一边数的是最近有动静的。两个数都真,只是数的人不同。你拿其中一个去核另一个,核不出来,因为本来就不是同一个东西的条数。
口径还包含它把什么算进去了、把什么排除了。有的会把刚上架的算进去,有的不算;有的会把某一种规格单独拎出来,有的合在里面。这些处理在页面上往往看不到,你只能从它的说明里找,找不到就记下这一条数不确定,别当确定的用。
具体一点:你发现两边的条数差了几十条,刚好跟最近新上架的数量差不多。这时候就值得去看看一边是不是把新上架的也算进去了。这一类差别不难发现,前提是你手上有两边各自的说明,或者至少知道去哪里查它们的定义。
三处关系里,口径是最晚显出差异的一处,也是代价最大的一处。范围不同的时候你比出来的是范围,节奏不同的时候你比出来的是时间,这两种差别都比较容易看出来。口径不同的时候,你比出来的东西看着像结论,其实是两个定义撞在一起。
具体一点:你按一边的口径做了一个判断,又拿另一边的数去验证,验证通不过,你会以为是另一边有问题。其实两边都按自己的口径算得好好的,问题出在你把它们当成同一个口径在用。这种错最难发现,因为每一步单看都没有错。
收一句:口径这一处最需要的不是算得比我快,而是它肯把定义写在旁边。你手上那一份如果写了按什么算、算的是哪一段、算的是哪一类对象,你就能拿它去和别的东西对;没写的话,它的数只能单独看,不能拿去核别人,这一点要先知道。
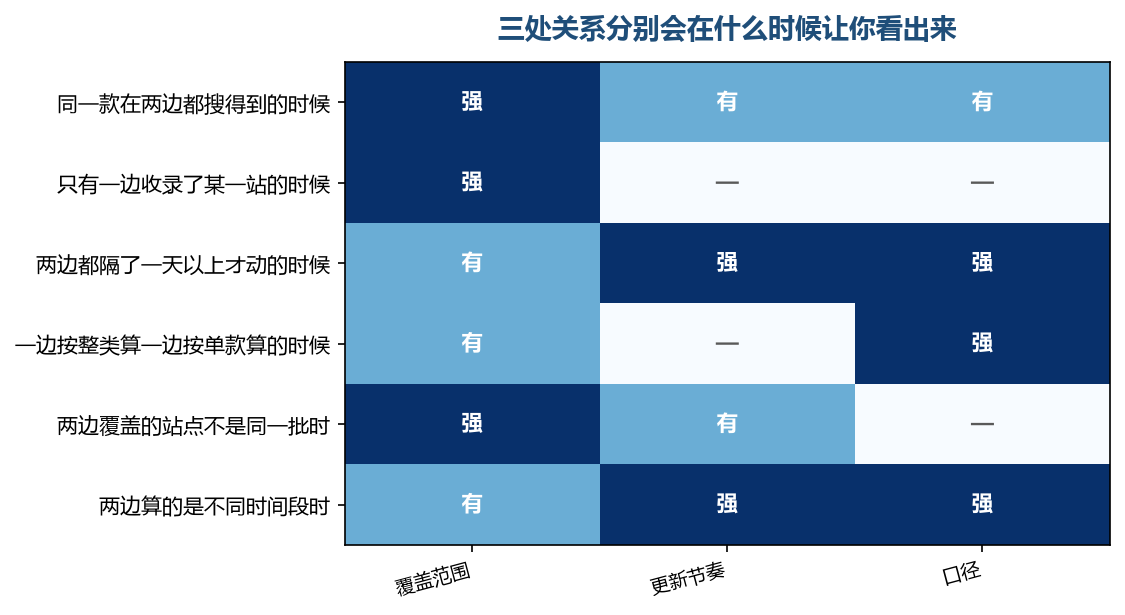
覆盖范围是最先显出差异的一处,口径最晚显出,但它一旦显出,前面的比大小就全作废了
两边对不上时先看谁
第一步先看两边说的是不是同一个东西。名字像不等于指的是同一件事,同一个名字底下可能是某一款,也可能是一整类;可能是这一个站点,也可能是几个站点的合计。这一层没对齐,后面看什么都是在别的地方找原因,找不到的。
第二步看覆盖范围。两边翻的站点是不是同一批,翻到第几层,按什么条件筛的。范围不同的时候,两个数的份量本来就不一样,比出来的差别从头到尾都是范围造成的,跟算法没什么关系,这一步能排掉一大半的对不上。
具体一点:你先问两边各翻了几个站点。如果一边一个、一边三个,那对不上的原因基本已经找到了,不用再往下查。这一步花的时间最少,能解释掉的对不上却最多,所以它排在节奏和口径前面,先做这一件最划算。
第三步看更新节奏。两边各是多久动一次,你手上这两个数分别是什么时候的。差一天的时候,先把这一天的距离放掉,看剩下的还差多少。很多时候放掉时间差之后两边其实就对上了,那这一趟你只需要记住一件事,它给的是前一日的。
具体一点:你看到两边差了一个档位,先别急着找算法。问一下两边的更新时间,如果一边是前一日的,一边是当天的,而这一天里刚好有活动,那这个差别已经有了一个很自然的解释。先把这个解释验掉,再考虑别的可能。
第四步才看口径。前两步排掉之后剩下的差别,才可能是口径造成的。这时候要看的是它怎么数、算的是哪一段、算的是哪一类对象,再看两边这几个定义是不是同一个。口径这一层最费时间,所以放在最后,前面的几步会把大部分情况筛掉。
具体一点:前几步走完,两边的范围一样、时间也一样,数还是不一样,那就有可能是口径不同。这时候你手上有两种选择,一种是去找两边的定义,另一种是把这两条记录都标上不确定,先不用它们做判断。两种做法都比硬比一个大小要好。
次序上有一条原则:先看最容易排掉的那一层。范围是最容易看出来的,节奏是其次,口径最费劲。按这个次序走,你花在找原因上的时间最少。反过来从口径开始查,你会花很长时间在定义上绕,绕完之后发现原来只是差了范围。
具体一点:有人习惯一发现对不上就去研究算法,翻半天说明,最后发现两边翻的站点就不是同一批。这一趟本来三十秒就能收掉。次序这件事看起来是小事,它管的是你每次遇到对不上要花多久,累起来差别不小。
还有一种情况是两边都对,只是你想问的问题不一样。你想问的是这一款本身怎么样,一边给你的是这一款,另一边给你的是这一类。这一类看着跟这一款有关,其实它回答的是另一个问题。这里要做的不是比大小,而是把问题问回给自己。
具体一点:你手上有两个数,一个说的是这一款,一个说的是这一类,两边差不多大。这时候你可能觉得两个都挺准,其实它们量的是两件不同的事,只是数值碰巧接近。拿这种巧合当互相印证,是最容易出错的一种做法,因为它看着太顺了。
两边对不上时,知虾那一层正好能当一个现成的参照:它给的数只在同类目同层级里横着摆得齐的那几个之间,你能比的也只在这几个之间。先看两边摆的是不是同类目同层级,层不相同的时候,两个数之间那点差距说明不了什么,回到同层再比才作数。
还有一层是:对不上不一定要解决。你手上两份来源,范围不一样、节奏不一样、口径也不一样,它们对不上是正常的。这时候值得做的不是把两边凑成一个数,而是把两边各自的条件标在旁边,用的时候按条件取,这比硬凑一个数稳得多。
具体一点:你在自己那份清单里给两条记录各写一行条件,一条写覆盖两个站点、前一日的,另一条写覆盖一个站点、当天的。下次看的时候,你就知道哪一条能跟哪一条比,哪一条只能单独看。这一行字花不了几秒钟,能省掉后面很多次犹豫。
收一句:先看谁这件事,答案是按最容易排掉的那一层往下走,先范围、再节奏、最后口径。这个次序不是谁规定的,是因为前面两层的差别看得出来,后面那一层看不出来。你按这个次序走,找原因的力气花在刀刃上,也省得在定义里绕圈。
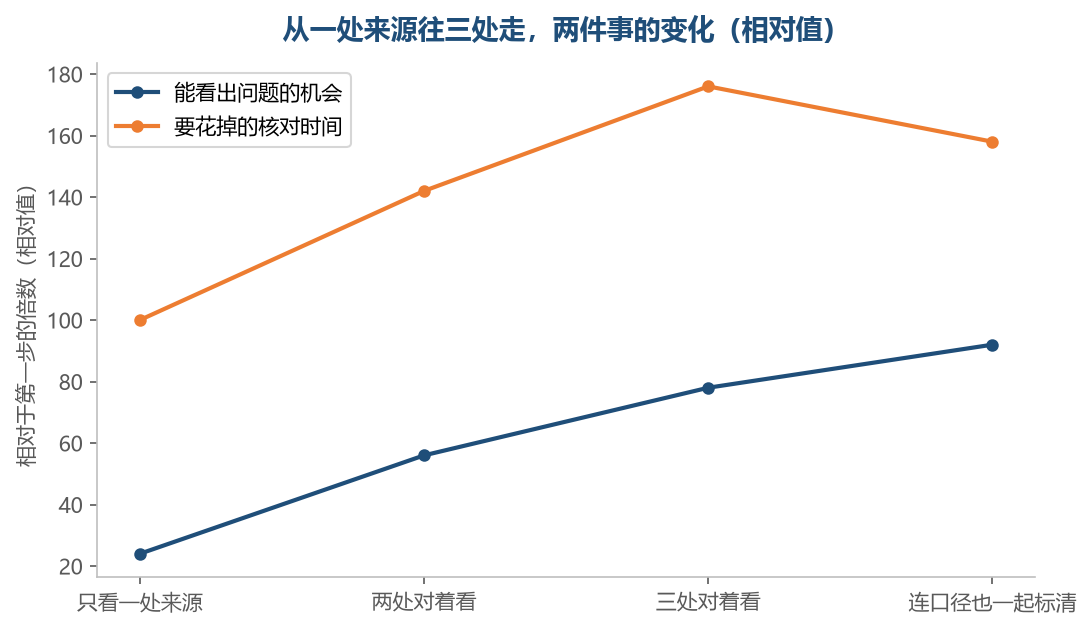
第二处来源带来的收益最大,第三处的边际收益就没那么高了,核对的时间反而开始往回收
怎么把两边摆在一起看
摆法很简单:先给每一份来源各写一行条件,写在数旁边,而不是记在别处。这一行写它覆盖哪几个站点、翻到第几层、什么时候更新、按什么算的。四样写下来通常只要一行字,可它把这一份数能用到哪儿说清楚了,后面用的时候不用再回忆。
具体一点:你在自己那份清单里给两条记录各写一行条件,一条写覆盖两个站点、前一日的,另一条写覆盖一个站点、当天的。下次看的时候,你就知道哪一条能跟哪一条比,哪一条只能单独看。这一行字花不了几秒钟,能省掉后面很多次犹豫。
第二件事是把两份来源各自看一遍,而不是合起来看。你先把这一份从头到尾看一遍,记住它是什么样子,再换另一份看一遍。合起来看的时候你容易把两边的印象搅在一起,分开看的时候各自的轮廓更清楚,也更容易看出两边是在哪一处开始不一样的。
具体一点:你在一份里看到某一类占的位置挺靠前,在另一份里看到它排在中间。分开看的时候,你只记住了两个位置;合起来看的时候,你容易在心里替它们折中出一个位置,那个位置两份都没说。折中这件事看着稳,其实是你自己造的第三个东西。
第三件事是给两边留一个可以对齐的口子,也就是找一个两边都有的东西。两边都收录的那一款、两边都提到的那个类目,拿它来对齐比拿两个不同的东西比靠谱得多。有了这一个对齐的点,你就能判断两边的差别是在整体上还是在某一些条目上。
具体一点:你先找一个两边都有的那一款,比较两边给它的数。如果这一款两边差不多,说明两边整体上对得挺齐,别的地方的差别多半是个别情况;如果这一款两边差很多,那差别的来源更可能在整体那一层上,这时候值得回头再从范围那一层查一遍。
第四件事是别把两边的数合成一个数。两个来源合起来算平均,看着得到了一加一的效果,实际上合出来的那个数两边都不认,也没有一个来源能替它说话。你要的是一个能拿去用的数,那就从两边的条件里挑一个合你这一趟的,用它,而不是造一个第三个数。
具体一点:你手上有一份覆盖三个站点的,一份覆盖一个站点的。你要看这一个站点的样子,就用覆盖一个站点的那一份,不要拿两份平均。平均出来的那个数既不是三个站点的样子,也不是一个站点的样子,它只是一个中间数,没有对应的那一层。
第五件事是把你经常对的那两份的条件固定下来,写在同一个地方,用的时候不再重抄。你会发现自己经常要对比的就是那两份,条件固定了之后,每次看两边的数你都知道自己比的是什么,也不用每次重新问一遍两边的范围和时间。
具体一点:你在笔记里固定记两行,一行是这一份的条件,一行是那一份的条件。以后每次看数,你顺手把数抄在这两行底下,过一阵回头看,你会发现哪些差别是反复出现的,哪些只是某一天的时间差,这个规律平时是看不出来的。
还有一件事:把对不上的那几次记下来。你会发现对不上往往集中在某些时刻,比如活动前后、上新集中的那几天。记下来之后,你就知道那些时刻的数字要格外小心,平时能直接比的两个数,在那几天里可能就不能直接比了。
具体一点:你在笔记里记一次对不上,写上是哪一天、哪两个来源、差在哪一处。攒上几次你会发现,多数对不上都发生在活动的头尾那两天。知道了这个规律,你在那几天里就会自动先看时间,而不是先看数的大小,这一步能省下不少误判。
拿知虾举例:它给的是前一日的数,这一层时间上的交代写在它的说明里,用的时候按这一条对齐就行。这一类东西里,肯把时间、范围、口径写在旁边的,你用起来省事得多;没写的,也不算错,只是你得自己替它补上这一行。
收一句:把两边摆在一起看,真正的工作量不在比大小,在给每一份数写清它自己的条件。条件写清了,比不比得成心里就有数;条件没写清,比得出来也不敢用。这一行字是整件事里最省力也最有用的一步,别把它放到最后才做。