
 最新跨境运营干货
 看多维度榜单信息
这一问问的是表分几种
把虾皮热销榜一般分成哪几种这句话放进搜索框,你要的是一份清单。你想知道市面上能碰到的热销榜大致分几路,每一路叫什么名字,各管什么用。这一问能给你的就是把这几路摆出来、分好堆。它不替你排先用谁,也不告诉你哪一路更值得走,那些事不归这一问管。
这一问问的是有哪几堆,不是哪一堆最好。问法落在分成两个字上,给的是堆,不是路径。清单的价值在于你知道了全部有几种可能,然后才能自己动手做减法。清单本身不解决选择,它只是把选择的材料摆齐。把这一层认清,你就不会指望一份清单直接变成一条能照着走的路。
这份清单在这里分三个大类。第一类是按累计卖出的总量排的表,它看的是从头到现在谁卖得多。第二类是按某一段时间涨得快慢排的表,它看的是最近谁动得急。第三类是按突然冒出来的量排的表,它看的是谁在不声不响的时候忽然抬了头。
三类表各自都有一个名字,也各自都有一套自己的规则。给它们起名字不是为了显得整齐,是为了你在跟别人说话的时候能指着说我现在看的是哪一类。名字是最省事的一层对齐,缺了它,两个人会一直在说不同的东西,说半天也说不到一起。
一个能对上号的场景是这样的。你在两个地方各看到一列名次,一列里排头的是一款卖了很久的老面孔,另一列里排头的是一款刚摆出来没多久的新款。你会以为其中一列出了错。其实一列是按总量排的,一列是按增速排的,两列都对,只是名字没说清。
还有一个场景,你在群里问别人哪款现在最热。有人回了一款老款,有人回了一款新款,两边都觉得自己有道理。这时候缺的不是答案,是那句这是哪一类表。三类表放在一起问谁最热,问的人自己也没把这一层想清,答的人自然也答不到点上。
这种分法还有一层用处,它让你看到自己手上那一张属于哪一类之后,立刻知道它答不了什么。一张按总量排的表答不了最近谁在动,一张按增速排的表答不了谁的盘子大。每一类表的能力都带着一截天生的空白,这一截空白是分堆分出来的。
有人会问,那我把三类都收下来是不是就齐了。收齐只是第一步。三类摆在一起的时候,它们的名次互相冲突,你会遇到同一款在一类里排前三、在另一类里排到几十位的情况。收齐之后要做的第一件事是减法,这一点跟直觉正好相反。
做减法的意思很直白,就是先问自己这一轮要看的是什么。你要看一个类目的家底,那就留按总量排的那一类。你要看最近的风往哪边吹,那就留按增速排的那一类。你要找还没被注意到的苗头,那就留按冒头量排的那一类。一次只留一到两类。
减法之后手上一般只剩一到两类表,剩下的放在一边不是浪费。它们还能用,只是不参与这一轮。把它们记下来,下一轮换一个目的的时候再拿出来,你就不用重新去收一遍。清单的价值有一半在第二次使用的时候才显出来,第一轮看不出。
这一段只负责把三类摆齐,不替你把它们排序。三类表之间没有高下,只有配不配得上你手上那个问题。你问的是家底,总量类就对得上;你问的是动势,增速类就对得上。配不上不是表不行,是这一问要的东西不在里面,换一张便是。
这一种问法只给清单,不给方案,这一点要说得再具体一点。方案里有一个先后,有一句先做什么后做什么。清单里只有几堆东西,它不写先后。你要的如果是先后,那你问的其实是另一句,那件事有它自己的段落,这一段不替它答,也不在这里先给半个顺序。
有人把清单收得越多越安心,觉得手上的牌多就不怕。牌多是好事,但牌多到分不清哪张能在这一轮用,反而会卡在原地。收和用是两个动作,收的时候可以贪,用之前必须减。把这两个动作分开,清单才帮得上忙,混在一起只会拖住你。
这三类表还有一个共同的脾气,它们都只写别人替你排好的结果,不写为什么。你从表上看到某款在往前挪,看不到它是靠降价挪的,还是靠评价堆上去的,还是靠上新节奏推的。这些原因都得你在表外面补,表本身不负责这一层。
补原因这件事本身就要花掉一部分时间,这也是为什么要先做减法。三类表都比对一遍,你要补的原因就有三套,时间会不够用。先减到一到两类,补起来才跟得上手上的活。这一步省下来的时间是实打实的,不是感觉上的。
回到这一问。它给你的是一份分好堆的清单,加上一句清单不是方案。清单到这里就交完了,后面怎么用、按什么顺序用,是另外一段的活。这一段不越界,也不在这里先把顺序替你排好,排顺序这件事留给该管它的那一段去说。
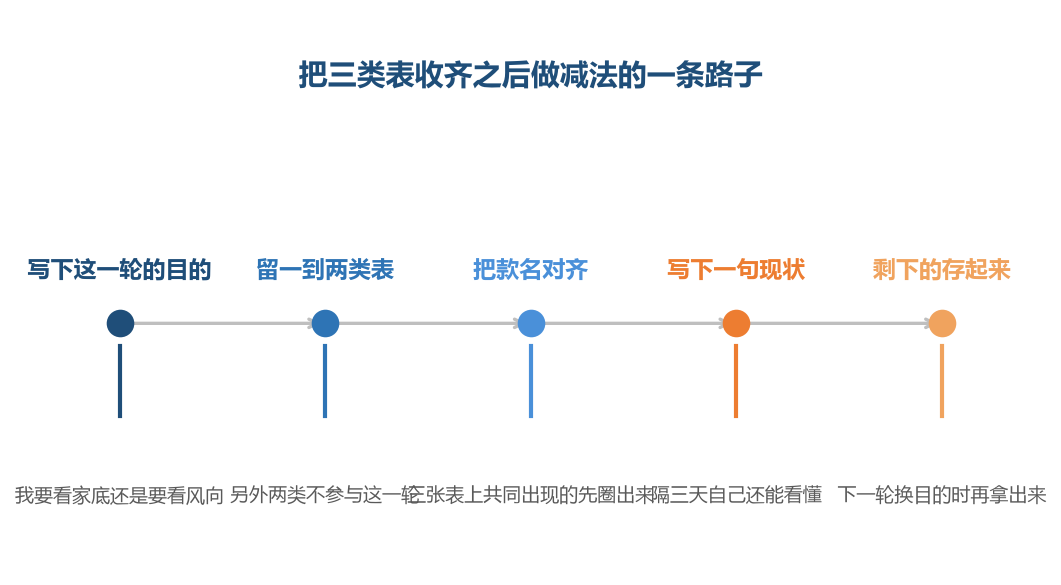
收齐只是开始,减法做完才轮得到手上的活(人造示例)
第一种:按总销量排的
第一类是按总量排的表,它的规则很简单,看的是某一款从这个站点摆出来到现在一共卖出去多少。数量大的排在前面,数量小的排在后面。这条线是直的,不拐弯,摆出来的名次也最稳,几天之内不太会大动,看起来最像一个固定的盘子。
这一类表最适合回答的问题是这个类目的家底是堆在谁手上。你打开它,看到的是一批卖了很久的老面孔,它们的量不是一天堆起来的,是慢慢累出来的。这类表给你的是一个稳定的盘子,而不是一个正在变的动静,两者不能互替。
它的空白也在同一个地方。一款去年的爆款今天可能已经停止增长了,可它还是挂在前面,因为总量还压在那儿。你从这张表上看不到它现在还在不在动,也看不到它的价格和评价有没有发生变化,这些都得你去别处补。
一个能对上号的场景,你想知道某个类目里前三名的量级大概在哪个档位。你在这一类表上一看就清楚了,它们的量比后面几名高出一大截,档位一下就落到眼前。这是这一类表最拿手的一手,别的两类表都替不了它这一手。
它的另一手是用来看一个类目的集中程度。如果前几名把绝大部分量吃掉了,那说明这个类目是几家在扛。如果前几名和后几名挨得很近,那说明量是散的。这个判断靠的是名次之间的间距,不靠名次本身是谁。
这一类表有一个天然的滞后。它算的是从头累计的量,昨天发生的事在它上面的体现很小。你拿它去看最近一周的变化,会看到几乎没动,然后误以为这个类目很平静。平静不是它想告诉你的东西,是你问错了它。
拿这类表去推新款的潜力,是最常见的一种错配。一款刚摆出来没多久的款,累计量当然小,它在总量表上自然排在后面。这不说明它不行,只说明这张表的尺子量不出它的势,你得换一把尺子再来问同一个问题。
反过来也一样,拿这类表去否定一款老款也不对。老款挂在前面,可能是它确实积累得厚,也可能是这个类目本身更新就慢,新产品进不来。两种情况的分别,这一类表自己说不清,得靠你在表外面再补一次。
这一类表的更新节奏通常比较慢,隔几天看一次和每天看一次,看到的差别不大。你按什么节奏去看它,不用太讲究,只要记住它的变化本来就慢,急也急不来。慢节奏的东西按快节奏去看,浪费的是你自己的时间。
有人会问,既然它动得慢,那还看它干什么。它解决的是另一类问题。你要判断一个类目值不值得进,先得知道里面的量是怎么分布的,而这件事只有这一类表答得最利落。动得快慢和答不答得上,本来就是两件事。
这一类表还有一个细节,同一款在不同站点上的累计量常常差一个档位。你把两边的名次并排看,会觉得其中一个站点很奇怪。其实两边开始卖的时间、活动节奏、用户习惯都不同,累计量有差别本身不奇怪,奇怪的是你拿它们直接对。
一个可以核对的核对方式是这样的,把这一类表上排在前面的几款名字记下来,过一周再看一次。如果这几款的相对位置基本没变,那说明这个类目的头部已经稳住了。位置换得多,说明这个类目还在洗牌,还没定下来谁是头。
这一段到这儿只讲清楚这一类表长什么样、答得上什么、答不上什么。它不跟另外两类比高低,因为三类本来就是为不同的问题做的。把这一类比下去,等于拿一把量长度的尺子去批评它量不出重量,这个批评本身立不住。
最后补一句清单上的位置。这一类不是清单里的第一顺位,也不是最值得先做的那一路。清单不排先后,只分堆。你手上那个问题指向它,它就是这一轮该留下的那一类;不指向它,它就留在一边等下一轮。
还有一句话得说在前头,这一类表上的名次是可以被人为拉长的。一款长期在跑的款和一个短期内集中出量的款,在累计量上看着可能差不多,可它们接下来的走势完全不是一回事。这一层,这张表不会提醒你。
所以看这一类表的时候,顺手把表上排前面的款分成两拨,一拨是长期在卖的,一拨是集中出量的。分完这两拨,你对这个类目的印象才不至于只停在一个总数上。这一步不难,却很少有人做完。
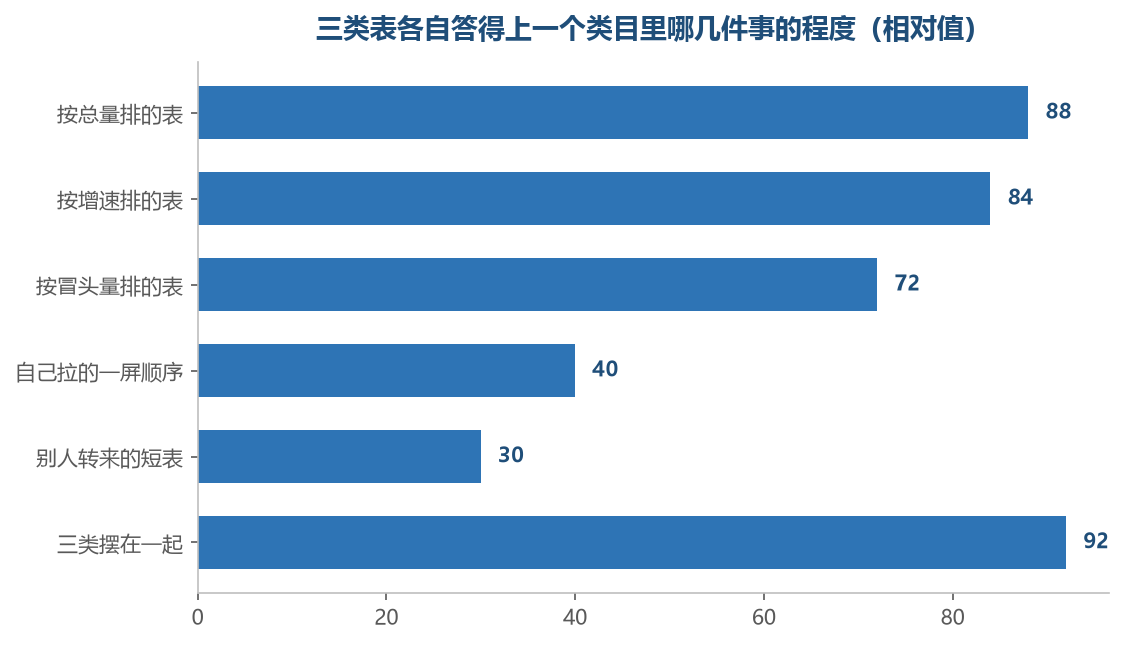
三类各答一段,摆到一起才补得齐(相对值)
第二种:按一段时间涨得快慢排的
第二类是按某一段时间涨得快慢排的表,它看的是最近这一段里,谁的量往上抬的速度快。比的是速度,不是总量。一款总量不大但最近抬得很快的款,能在这一类表上排得很靠前,这在总量表上几乎不会发生,两张表问的不是同一件事。
这一类表最适合回答的问题是风最近往哪边吹。它把时间压缩到最近一段,把从头到现在的老账抛开,让你看到的是当下正在发生的变化。你要跟上最近的节奏,就得靠这一类表,别的东西替不了它。
它的空白在于速度这东西很容易被一次小动作放大。一款本来基数很小的款,多卖了几十件,比例上就会显得涨得很快。你从这一类表上看不到基数是多少,也看不到这波上涨是靠什么带起来的,看到的只是一个幅度。
一个能对上号的场景,你在一个类目里连着看了一周,画面上冒出来一款从没见过的新面孔,位置还不算靠前,但在往上走。这时候你去翻总量表,很可能压根找不到它。两张表回答的东西不在一个层面上,一张答动势,一张答家底。
这一类表最容易让人兴奋,也最容易让人踩空。兴奋是因为它天天在换脸,看着有生气。踩空是因为它上面排前面的款里,有一批是一次性事件带起来的,那个动力过几天就没了,表上不会提前告诉你它什么时候停。
拿这一类表去判断一个款能不能长期走,是它天生不擅长的事。它只能告诉你最近这一段在动,动完之后会不会停,它不知道。你把最近在动直接读成以后能走,中间跳过了一大截,这一截正是最花时间的那一截。
这一类表还有一个特点,它的名次对时间窗口特别敏感。你把窗口从近七天换成近三十天,排在前面的款可能换掉一半。同一个类目,同一个站点,就因为窗口不同,看到的名单就不一样,两张名单摆一起像两个类目。
所以这一类表最要紧的一行不是名次,是它写着的那个窗口。你看到它没写窗口,或者写得很含糊,那这张表的可用程度就要打一个折扣。名次是可以复述的,窗口没写清楚的名次没法复述,也没法跟别人对齐。
这一类表的更新节奏通常比总量表快,隔一天看和隔三天看,差别会很明显。你按什么节奏去看它,得先看它自己更新的节奏。你比它勤,看到的都是重复的内容;你比它懒,错过的就是它唯一想告诉你的那个东西。
有人会问,那这一类表会不会把老款漏掉。会的,而且是故意漏掉。一款盘子很大的老款,最近没怎么动,它的增速自然排不到前面去。这不是漏,是这一类表问的问题本来就不在老款身上,老款该去另一张表上找。
用它的时候有一件顺手的事可以做,把这一类表和总量表并排放在一起看。一款在总量表上位置不靠前、在增速表上位置很靠前,这样的款值得你多看一眼。并排看是为了找出这种差,不是为了给两张表排一个名次先后。
一个可以核对的细节,同一款在增速表上连着出现三天的位置,比它只出现一天的要多一层意思。连着出现说明它不是一个偶然事件带起来的,是有东西在持续推它。这一条不用工具,你自己看两三次就能看出来。
这一段也是只讲这一类表的样子、它能答什么、答不了什么。它跟另外两类之间没有高下,只是三把尺子中的一把。你要量的是速度,就用它;你要量的是家底,就去用另一把。用错了尺子,问题本身不会因此变小。
清单上它的位置同样不由这一段决定。它是不是这一轮该留下的那一类,取决于你手上那个问题问的是什么。清单只负责把它标好名字摆在那儿,选不选是你的动作,跟它本身的成色没有关系。
这一段还要说清一件事,这一类表上的名次往前,不等于这款值得跟。名次往前只说明它最近动得快,动得快可以有很多种来路。你要判断值不值得,得去补它的来路,那一步不在这一类表的能力范围里。
最后收一句,看这一类表的时候把窗口两个字盯住。窗口写了,名次才有上下文;窗口没写,名次只是一串好看的数字。数字本身不会骗人,可它也不会主动交代自己是从哪一段时间里算出来的。
| 这一类的名字 | 它量的是什么 | 它答得上什么 | 它答不上什么 | |||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 按 | 总 | 量 | 排 | 的 | 表 | |||||||||
| 从 | 头 | 到 | 现 | 在 | 一 | 共 | 卖 | 出 | 多 | 少 | ||||
| 家 | 底 | 堆 | 在 | 谁 | 手 | 上 | 、 | 集 | 中 | 到 | 什 | 么 | 程 | 度 |
| 最 | 近 | 谁 | 在 | 动 | 、 | 当 | 下 | 是 | 什 | 么 | 状 | 态 |
第三种:按突然冒出来的量排的
第三类是按突然冒出来的量排的表,它看的是谁在不声不响的时候忽然抬了头。这一类表的名次往往变化最快,一天之内整张脸的换法都可能不一样。它盯的是那种还没被大家注意到的冒头,出来的时间比另外两类都早半步。
这一类表最适合回答的问题是有什么东西我还没看见。它不是让你去看那些已经摆在明面上很久的款,是让你去看那些刚抬头、位置还不高的款。它给的是提醒,不是结论,提醒要先经过你自己那一步才能变成能用的东西。
它的空白在于冒头的原因它一概不说。一款忽然多出一批量,可能是上新节奏推的,可能是某个活动带的,也可能是短期的一次性事件。你在这一类表上只能看到有人动了,动的原因要你自己去表外面找,表上一格都不会写。
一个能对上号的场景,你在这一类表上看到某款从很靠后的位置往上跳了一大截,名字你没见过。你去翻总量表,它在那儿根本排不上号;你去翻增速表,它可能刚够得着。这类表给的就是这一层早半步的提醒,别的表到不了这么早。
这一类表有一个很实用的地方,它能帮你发现那些还没进入视野的款。你要找的如果是一个还没被抢的位置,这一类表比另外两类更早碰到。它给的不是答案,是一条线索,线索的价值在于它出现得早,早到还来得及看。
它的风险也在同一个地方。冒头这件事本身可以被一次小动作做出来,一款本来基数就小的款,多动几下就能在比例上跳得很高。你把每一次冒头都当成信号,就会被大量的噪音牵着走,最后分不清哪一条值得跟。
拿这一类表去判断盘子大小是它最不擅长的事。它上面基本看不出量级,一款冒头很猛的款,总量可能只是很小的一个数。你要的是量级,就得去用总量表,别在这张表上找,找也找不到,还容易把小的当成大的。
这一类表还有一个细节,它的冒头经常集中在几个特定的时间点上,比如某个活动开始的前后。你在看它的时候,顺手看一眼这个时间点本身,就能把一部分一次性事件先认出来,剩下的再慢慢查,这样筛一遍会省不少力气。
这一类表的更新节奏通常最快,有的甚至是当天就换。你按什么节奏去看它,得先想清楚你手上的活能不能跟上。跟不上就少看几次,看它三次里能对上两次的规律,比天天盯着看一遍更省力,也更看得住。
有人会问,那这一类表是不是最有用的。三类表里没有哪一类在总体上更管用,它们只是在回答不同的问题。你手上那个问题如果是找还没被看见的苗头,它就最对得上;如果不是,它给不了你要的东西,硬看只会浪费时间。
用它的时候还有一个顺手的动作,把冒头的款名记下来,隔三天再回来看一次。三天后还在往上走的,和已经掉回去的,是两批不同的东西。这个动作花的时间很少,筛掉的噪音却不少,值得作为看这张表的一个固定动作。
一个可以核对的细节,同一款在一张冒头表上今天出现、明天消失,说明它那一次冒头只是一次性事件。连着出现好几天的,才值得你把它名字留下来,放到下一个动作里去查,这样留下来的名单会短很多,也准很多。
这一段同样是只讲这一类表的形状和它的能力边界。它不跟另外两类比高下,它只是清单上的第三堆。三堆都摆齐了,你才知道自己要做的那道减法是从哪几件里减,减之前先得知道一共有几件。
清单上它的位置同样不由这一段来定,也不由这一类表的脾气来定。这一段只把名字和它能答的问题说清楚,剩下的留给你的目的来判断。清单到这里就交完了,不往后多走一步,也不替别的段落先答半句。
再补一句,这一类表上冒头的款,很多过一阵就会自己安静下来。这不是坏事,是它本来就在干筛的活。你把它当成一个筛子用,比把它当成一份名单用要顺手得多,筛完留下来的那几个才是你要花时间的东西。
最后一句留给用法上的分寸。这一类表看看就好,别因为它变化快就不停地刷新。你刷得越勤,看到的越是同一批噪音在反复出现,真正值得注意的那一条反而被淹没在里面,看不出来。
三种表各自适合回答什么
按总量排的那一类,适合回答的是家底和集中程度这两件事。你想知道一个类目里的量是堆在几家手上,还是散在很多家手上,这一类表给的最直接。它答的是静态的结构,不答当下的动静,这一点得先记清楚。
它也适合回答一个款在这个类目里能站到哪个档位。你把它的累计量和表上的几个档位对一下,位置就出来了。这个位置不说明以后怎么样,只说明它到现在为止攒了多少,攒得多不等于以后还涨。
如果那个站点的用户习惯就是跟风,或者这个类目本身更新就慢,那这一类表还会顺带告诉你一件意想不到的事。几个月不怎么动的老面孔会一直挂在前面,这说明这个类目的头部已经很难被掀动了,新人进不去。
按增速排的那一类,适合回答的是最近的风往哪边吹。你想知道这一段时间里谁在往上走,谁在往下掉,这一类表是最干脆的一把尺子。它答的是当下的方向,不答方向能撑多久,撑多久要去别的地方找线索。
它也适合用来给自己排一个近期的看盘顺序。哪几款在最近这一段里动得勤,你就先去看那几款。这个顺序只在这一段时间里有效,过了这段就该重新排一次,别把它当成一份固定的名单一直用下去。
这一类表还适合回答一件事,某个类目最近是不是整体在热。如果表上冒出来的新面孔比前一阵多,说明这个类目最近在换血。这一条比单个款的名次更有意思,因为它说的是一片地方,不是一个人,一片地方的变化比一个人更耐看。
按冒头量排的那一类,适合回答的是有什么东西我还没看见。它给的是最早半步的提醒,适合那些想赶在别人前面看到苗头的人。它答的是有没有,不答值不值得,这两件事中间还隔着一整段要你自己走的路。
它最适合配合一个很小的动作一起用,把冒头的名字记下来,隔几天回访一次。回访之后还在的留下,掉下去的划掉。这样筛上几轮,剩下的就是值得拿去细看的那几个,这一步跟判断好坏无关,只是筛。
三类表各自还都有一件不擅长的事,这一点值得单说。总量表不擅长看当下的状态,增速表不擅长看长期能不能走,冒头表不擅长看量级。每一类的强处和短处其实长在同一处,因为它们的规则本来就是一根线,线之外的东西量不到。
有人会问,那我能不能三类各看一页,凑成一份完整的判断。能凑,但凑出来的东西不能直接当一个结论用。三类表各自的口径不同,名次混在一起没有可比性,你得先把它们分开放,再分头读,混着读只会读出一团乱麻。
这一段也不替三类表排先后。哪一类适合你的问题,取决于你的问题问的是什么。三者之间只有配不配得上,没有谁强谁弱。把这一点记住,你看清单的时候就不会下意识地去找那个第一,也不会因为找不到而觉得自己没读懂。
说个能让三类表各自对上号的场景。你想进一个新类目,先看总量表认家底;你在里做了一段时间,看增速表认风向;你想盯有没有新对手冒出来,看冒头表认动向。三个场景三把尺子,各管一段,谁也替不了谁。
一个可以核对的细节,同一个类目里,三类表上排第一的往往不是同一款。这不是哪一张表出了问题,是三张表各自在问不同的问题。你把这个差别记住,就不会再拿一张表的名次去质疑另一张,也能省下不少争论的时间。
这一段把三类表各自的能力边界说清了,清单到这里就算摆完。每一步都停在这里,不再往下一步的用法上伸。用法是另一段的事,这一段不替它说话,也不替它先给一个半句,给了就是越界。
补一句,三类表放在一起的时候,最容易犯的错是拿其中一张的量级去衡量另一张上的名次。量级和名次来自两套完全不同的算法,放在一起比,比出来的东西既不是量,也不是势,什么都算不上。
最后再说一次清单的分寸。它把三堆东西摆出来,给每一堆起好名字,说清每一堆答得上什么。剩下的减法、排序、用法,都不在这个范围里。清单该做的到这儿就做完了,多做的部分反而会把它自己变回一份方案。
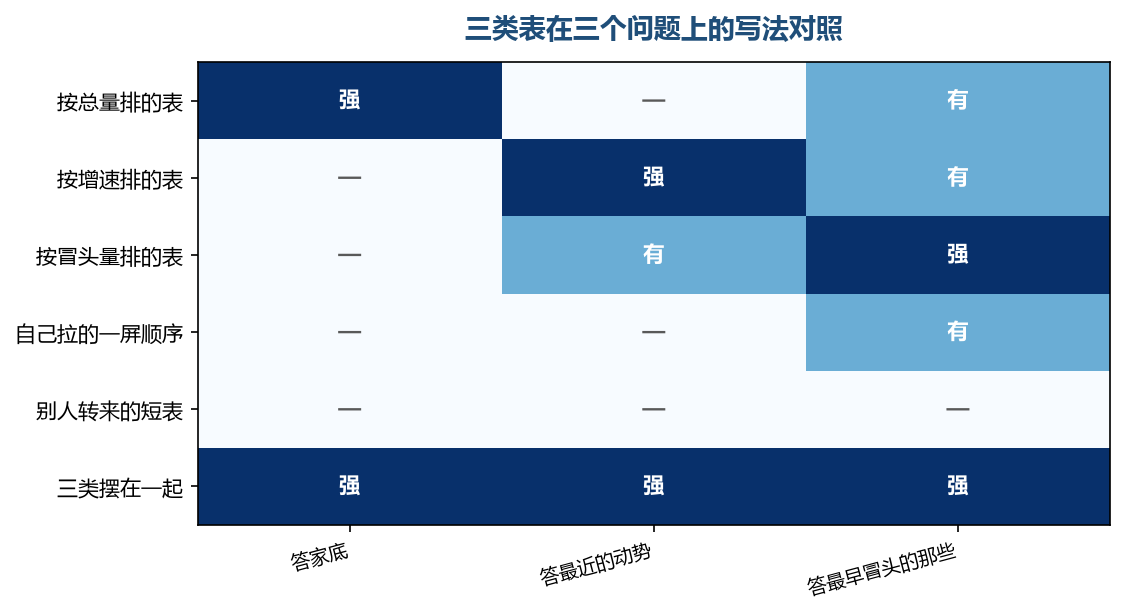
三类表各答一段,摆在一起才补得上彼此漏掉的那一层
只拿一种当全部会漏掉什么
只拿一类当全部,最容易漏掉的是时间这一层。总量表看的是从头到现在,增速表看的是最近一段,冒头表看的是当下的一跳。你把其中一类当成整体,等于把另外两个时间尺度直接从视野里抹掉了,抹掉的东西不会自己回来。
只拿总量表当全部,你会漏掉正在发生的动静。一个类目里刚刚冒出来的新品,在这类表上完全看不见,因为它攒的量还太小。你以为这个类目很平静,其实下面已经在动了,只是这张表量不出来,平静是它给你的错觉。
只拿增速表当全部,你会漏掉家底。你会看到一批动得很快的款,但看不出这些款后面的盘子有多大。同样一段增速,一款是从很小的基数抬起来的,另一款是从很大的基数往上走,这两件事完全不是一回事,落到动作上也完全不同。
只拿冒头表当全部,你会漏掉位置。你会收到一大堆刚抬头的名字,可这些名字在整个类目里站到哪儿,表上没说。你拿着一堆线索却落不到具体的地方,最后还是要回头去翻另外两张表,那一步绕不过去。
还有一种漏法更隐蔽,只拿自己顺手的那一类当全部。每个人手里都有一类表看得最熟,熟到下意识地先打开它。另外两类不是不存在,是你已经很久没打开过它们了。习惯造成的漏,比信息不够造成的漏更难发现。
有人会问,那我把三张表都记在心里,是不是就不会漏了。记住三种不等于同时用三种。你在某一个具体的动作里,通常只该用其中一类。另外两类的用处,是在你要换问题的时候能马上接上,不是样样都要一起摆出来。
一个具体的场景,你按增速表挑了三款准备细看。看完之后觉得都不错,可你没去查总量表,不知道这三款在各自的类目里是刚冒头还是已经到顶。这一步没做,后面的话都没有着力点,判断也就悬在半空。
反过来也一样,你按总量表挑了几款老面孔,看起来扎实。可你没去看增速表,不知道这几款最近是不是已经在往下走了。这两种漏法都很常见,它们都不是表的问题,是只拿一张表当全部的问题,换谁来看都会漏。
这个漏法在时间上的代价最大。你按一张表做了决定,过了一阵发现方向不对,回头查才发现另一张表早就把它们摆出来了。你不是没拿到那张表,是那一次压根没打开它,表就在手边,人却绕过去了。
把几种摆到一起看,第一件要做的事不是看名次,是看名字。把三张表上共同出现的款名先圈出来。三张表上都有的款,说明它既攒下了量,最近也在动,还在被人注意到,值得单独拎出来放在一边。
第二件要做的事是看那些只在其中一张表上出现的款。只在总量表上出现的,多半是已经稳下来的老款;只在增速表上出现的,是最近在动的;只在冒头表上出现的,是最早的那一批。三种位置对应三种看法,别用一种读法去读三张表。
第三件要做的事是给这三组款各写一句话,写到你自己能看懂就行。这一句话不用漂亮,只要能让隔了三天的你一眼看出这一组当时是个什么状态。写完这句话,摆到一起看这件事才算做完,否则你只是看了一遍而已。
摆到一起看不是把三张表的名次加起来算总分。名次来自三套不同的规则,加起来没有意义。摆到一起看的对象是那些款的名字和它们各自出现的位置,不是数字本身,这一点弄反了,后面做的都是白工。
这一段的边界也要说清。它讲的是三类表放在一起会互补,不检查单看哪一类会漏掉什么。到这里就打住,不往下讲先看哪一类、按什么顺序看。另外一层顺手说清,这一类清单要留在手上慢慢用,只能靠你自己记。知虾摆出来的同样只是公开面上谁都能看到的那些数,它不替你翻别人店里的账,也没有把一大批店铺数据整包搬走那种用法。
补一句,三类表放在一起看,花的时间确实比看一类多。多花的那部分是值得的,因为它换回来的是一个完整的画面。但前提是你已经做过减法,手上就一两个目的,不是把三张表全搬进同一个决定里,那样只会把自己绕晕。
回到这一问。它要的是一份分好堆的清单,加上一句清单不是方案。清单到这里交完了,剩下的选择动作归你自己。这一段不替你把三堆排个先后,也不暗示哪一堆更适合先动,这两件事都不在清单的职责里。
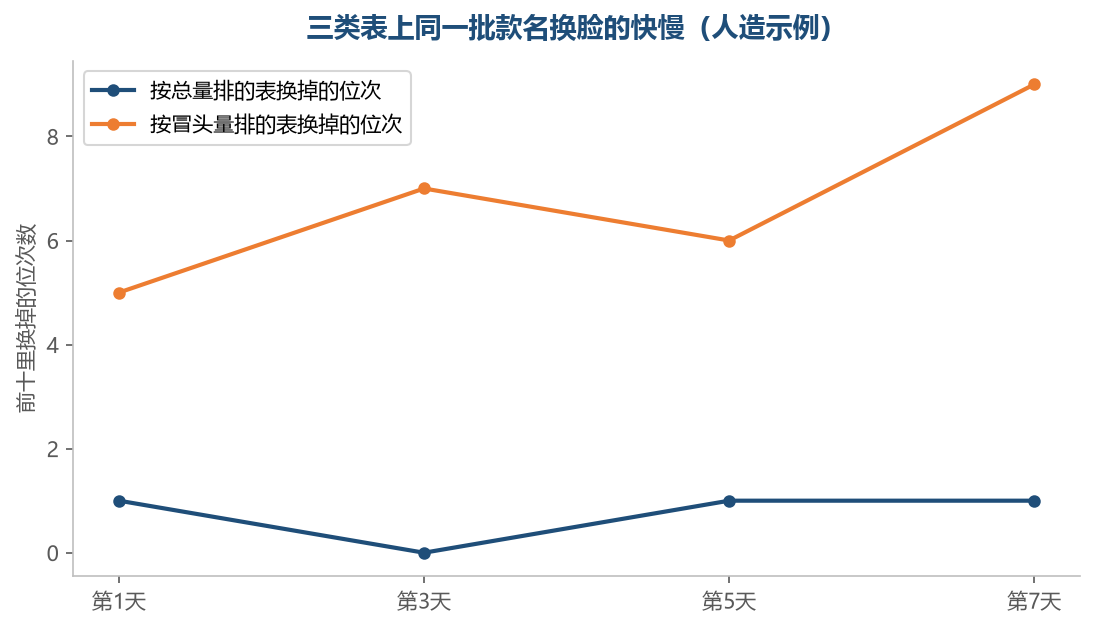
三类表换脸快慢差得远,收齐之后要按快慢分开读(人造示例)
怎么把几种摆到一起看
把几种摆到一起看,有一个能马上上手的办法,先做一张只有两列的小纸。左边一列写款名,右边一列写这个款在哪几类表上都出现了。三张表都有的写三个字,只在一张上有的写一个字,写完这一张纸,减法的一半就做完了。
第二步是按你这一轮的目的给这张小纸排序。你这一轮要的是家底,就把三张表都出现、且在总量表上位置靠前的先挑出来。你这一轮要找苗头,就把只在冒头表上出现的先拎出来。顺序由目的定,不由表定,表没有先后这个概念。
第三步是给挑出来的那几个各留一格,写下你还不知道的那件事。比如某款在增速表上很靠前,你不知道它那波上涨是靠什么带起来的。这一格写下来的东西,就是你接下来要花时间去补的地方,写字这一步比翻表那一步更值钱。
第四步是把剩下的先放到一边,不要边看边留着。清单收得全的时候,人会舍不得放下任何一项。可你这一轮只做一件事,留在手上的东西多了,注意力会被分薄,最后每一件都只做了一半。一开始就少留几件,反而更容易做完。
这四件事里没有一件需要工具,也没有一件需要权限。它要的只是一张纸和一点耐心,加上愿意把手上那份清单做薄一点的决心。做薄这件事本身,就是清单这一问真正的用法,不做薄,清单就一直只是一堆名字。
有人会问,那我把三类表上的款都记下来,是不是更保险。记下来本身没坏处,但你下一次打开这份记录的时候,得能一眼看出哪几个是这一轮要动的。如果看不出,这份记录就只是一堆名字,帮不上你,还会拖慢你。
一个能对上号的细节,同一款在三张表上出现的位置如果差别很大,比如在总量表上排得很靠后,在冒头表上却排得很靠前,这款往往是最值得先看的那几个之一。位置之间的落差本身就是一条线索,比名次本身更有信息。
反过来,同一款在三张表上位置都差不多,说明它现在处在一个比较稳的状态,没有特别快的动作,也没有突然的冒头。这样的款不是不值得看,只是它不会给你带来意外,你把它放到后面去也来得及,不用急着开它。
这一层参照面在哪里找,知虾给的东西正好卡在这个位置上:同类目、同层级里那几个公开可比的数,谁来打开看到的都是同一批,跟谁家店铺里的内部账没有关系。你在小纸上写的款名如果要找一个共同的参照面去对,对的就是这一层。
换句话说,凡是只有进了别人账号才看得到的东西,那边一样没有。清单上那些款要在公开面上对不对得上,你只能拿公开面能看到的数去对,这一点在做减法的时候就要认下来,别指望别的东西能替你把这一格补上。
小纸做完之后,你会发现自己手上的款从一长串变成了一小撮。这一小撮不是评出来的头几名,是这一轮最对得上你目的的那几个。这两句话差别很大,前者是评价,后者才是清单用法,把两者混起来就又会滑回清单本身。
再补一个小动作,把这张小纸和它当天记下的那三张表放在一起存。过一周回头看的时候,你能知道自己当时是在什么信息下做出的选择。这个动作不需要额外的判断,只要养成存一下的习惯,事后查起来会省很多事。
这个动作做上一段时间,你会发现真正花时间的不是看表,是把几张表的款名对上。上款名这一步做顺了,后面补原因那一步就快了。省下来的时间,够你多看一两个类目,这才是减法真正给你的东西。
这一段讲的都是把清单用薄的动作,没有一句在讲判断好坏。哪些款值得做、这个位置值不值得进,那是另一段的事。这一段只到把清单减薄为止,减完就交出去,不往下替别人答,也不在最后加一句结论。
补一句边界的话。三类表之间的互补,不等于三类必须同时看。你做减法的目的,恰恰是让自己在一轮里只看一到两类。全看一遍不是更认真,是把清单重新变回了方案之前的那个样子,兜了一圈又回到起点。
最后留一句给你自己,你手上这三类表收齐了,接下来该留哪一类。如果这个问题你还答不上来,那你要的不是更多的表,是你这一轮到底想问什么。把目的写下来,清单自然会变薄,不用谁替你排。